Ziyao (Adonis) Zeng 曾子尧

Ph.D. Student in Computer Science
Yale University

I am looking for a full-time research position starting Dec. 2026

I'm a Ph.D. student in Computer Science (2023 - [Expected] 2027) at Yale University, advised by Prof. Yuval Kluger (primary) and Prof. Daniel Rakita. Previous to that, I obtained my B.Eng. in Computer Science (2019 - 2023) at ShanghaiTech University, minor in Innovation and Entrepreneurship. During my PhD, I did research internship at Nvidia Research and Meta Reality Lab.

I conduct research on Multimodal Learning for Agents and Robotics, especially Vision-Language Models (VLMs), LLM Agents, Diffusion Models, World Models, and 3D Vision. My line of work in "Language for 3D Vision" explores how vision-language models can perceive and understand the world like humans do.

News

Collaborators

I was also fortunate to intern at Shanghai AI Lab and UISEE during my undergraduate studies.

Reviewer Services

CVPR [2025 Outstanding Reviewer], ICCV, ECCV, ICML, ICLR, NeurIPS, ACM MM, AISTATS, ICASSP, BMVC, ICRA, TCSVT (journal), TMLR (journal)
Ziyao Zeng

Research

Multimodal Representation Learning towards Agentic AI

Since the age of 13, deeply touched by Foundation by Isaac Asimov, my dream has been to create an AI who can think like humans (just like the dream of Prof. Jürgen Schmidhuber). When humans perceive the surrounding environment, we see (vision), hear (audio), feel (tactile) simultaneously to reason (language) and understand (neural signal), then interact (action) with the world. Therefore, I conduct research on Multimodal Representation Learning for Agentic AI, which spans both embodied agents (robotics) and digital agents (LLM/VLM-based agents). Despite differing in their input modalities and action spaces, they are unified by a common goal: the need to perceive, reason, and act intelligently within their environments.

My key research questions are (1) how to obtain good multimodal representations for agents and robots, and (2) how to use those representations to make agents and robots better perceive, reason, understand, and interact with the world. Specifically, my line of work in "Language for 3D Vision" (DepthCLIP, PointCLIPv2, WorDepth, RSA, Iris) explores how vision-language models can perceive and understand the world like humans do. Besides perceiving and understanding the world, I am exploring predicting the world and acting within it, including world models (DTWM, OpenLongTail, CrashTwin), LLM Agents (RuleSmith, SciAgentArena, CCPO), and 3D visual coding (3DCodeVerse). In the long term, since I want to build an AI who thinks like humans, I also care about AI consciousness and welfare (spiritual bliss attractor).

Publications

First/Co-first author publications are highlighted.

(* indicates equal contributions)

VLMs 3D Vision LLM Agents Diffusion (World) Models Multimodal Robotics

2026

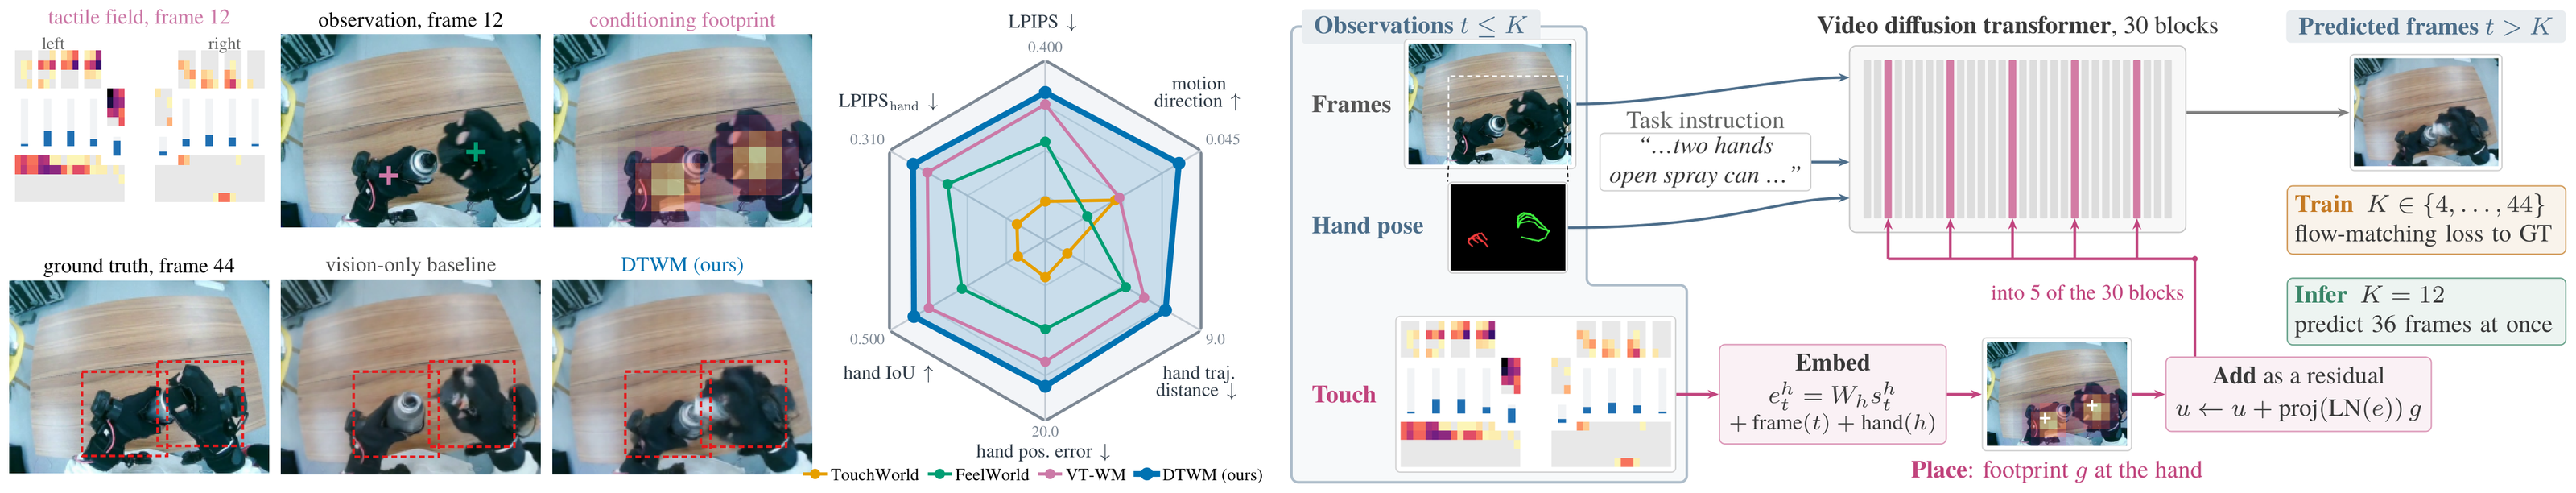
DTWM
Dexterous Tactile World Model

Ziyao Zeng, Xiatao Sun, Hao Wang, Yueyang Pan, Zhengxiang Yu, Fengyu Yang, Tianyu Liu, Zhiwen Fan, Daniel Rakita

Preprint | project page, code

Diffusion (World) ModelsMultimodal
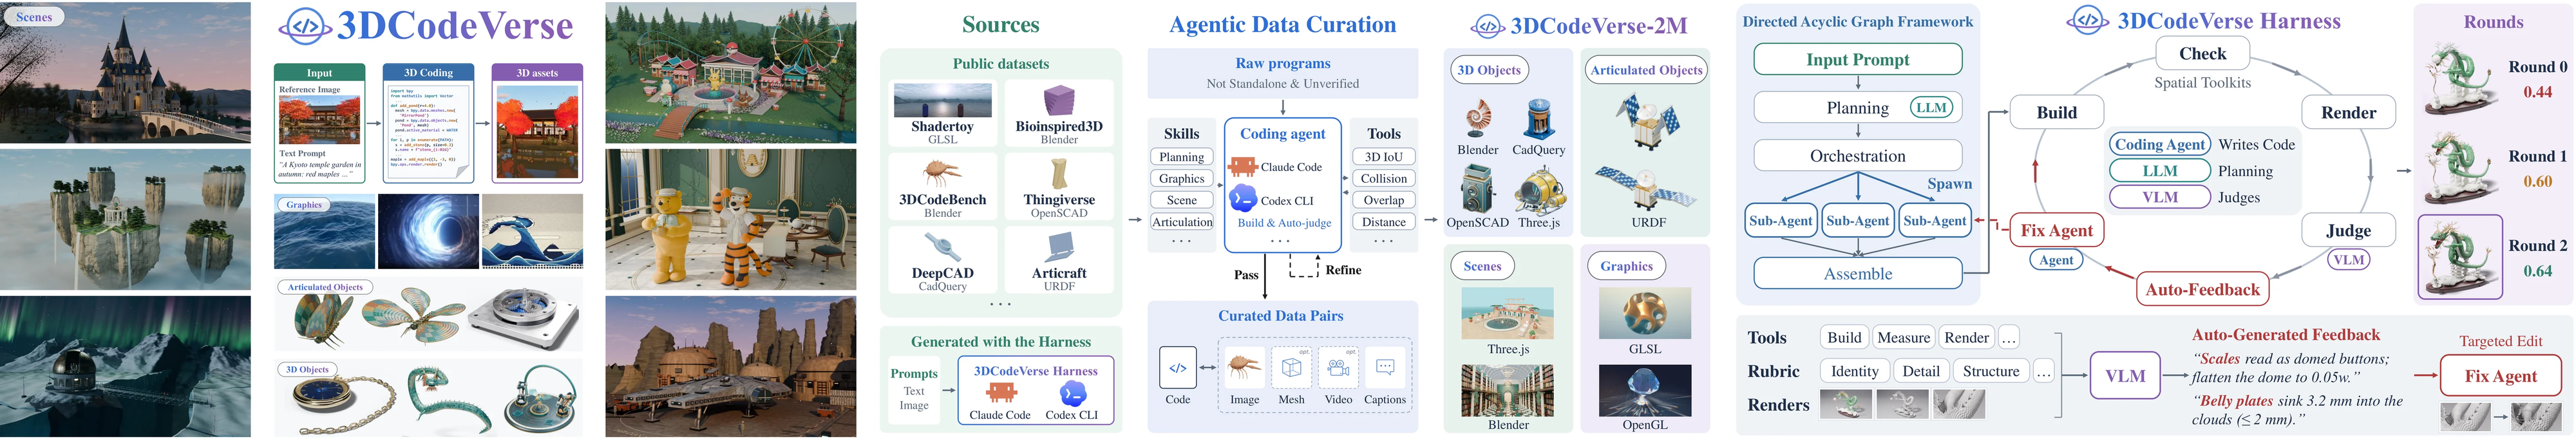
3DCodeVerse
3DCodeVerse: Exploring 3D Worlds as Code

Yipeng Gao*, Ziyao Zeng*, Jinfa Huang*, Yijiang Li*, Haolin Xiong, Wang Qin, Xinlei Yu, Youheng Yao, Jie Zhang, Kun-Yu Lin, Rong Liu, Yinyuan Zhao, Yajie Zhao, Meiqi Guo, Jiebo Luo, Lei Shu, Yunhao Ge, Xinyu Hu, Laurent Itti

Preprint | project page, code, dataset

LLM Agents3D Vision
SciAgentArena
SciAgentArena: Benchmarking AI Agents for Addressing Scientific Challenges Across Scales

Tianyu Liu*, Allen Xin Wang*, Antonia Panescu*, Lisa Xinyi Chen*, Wenxin Long*, Xinyu Wei*, Yueqian Jing*, Ziyao Zeng*, Jihang Chen, Sihan Jiang, Ziqing Wang, Siyi Gu, Siyu Chen, Xinyang Hu, Haoran Shao, Leqi Xu, Wangjie Zheng, Zhiyuan Cao, Ada Fang, Botao Yu, Oliver Sun, Rex Ying, Arman Cohan, Qingyu Chen, Lingzhou Xue, Kaize Ding, Yuanqi Du, Wengong Jin, Zhuoran Yang, Marinka Zitnik, James Zou, Hua Xu, Hongyu Zhao

Under Review of Nature | project page, code, dataset, paper

LLM Agents
Iris
Iris: Integrating Language into Diffusion-based Monocular Depth Estimation

Ziyao Zeng*, Jingcheng Ni*, Daniel Wang, Patrick Rim, Younjoon Chung, Fengyu Yang, Byung-Woo Hong, Alex Wong

CVPR 2026 | NECV 2025 Oral Presentation (18.75%) | project page, code, paper

VLMsDiffusion (World) Models3D Vision
RuleSmith
RuleSmith: Multi-Agent LLMs for Automated Game Balancing

Ziyao Zeng, Hao Wang, Chen Liu, Youheng Yao, Jingcheng Ni, Tianyu Liu, Xiatao Sun, Fengyu Yang, Chenyu You, Xiaofeng Liu, Daniel Rakita, Ronald R. Coifman, Yuval Kluger, Zhiwen Fan

NeurIPS 2026 | NE Agents Day 2026 | project page, code, paper

LLM Agents
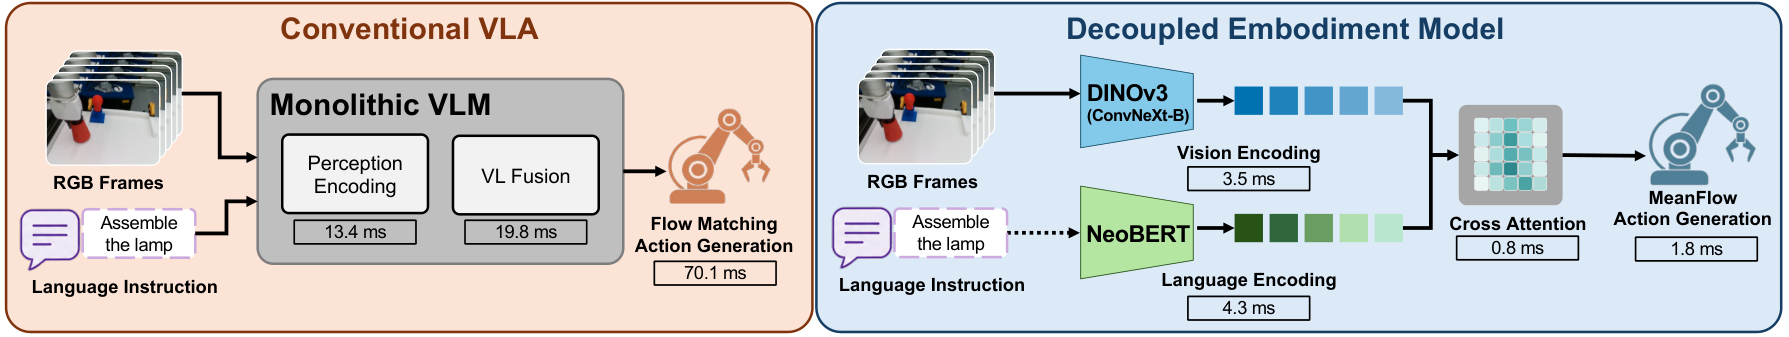
Decoupled Embodiment Model
Decoupling Vision, Language, and Action for Efficient Multi-Task Robot Policies

Xiatao Sun, Chen Liang, Ziyao Zeng, Qian Wang, Haoyang Zhang, Yue Sun, Qiucheng Li, Daniel Rakita

Preprint | code, paper

VLMsRobotics
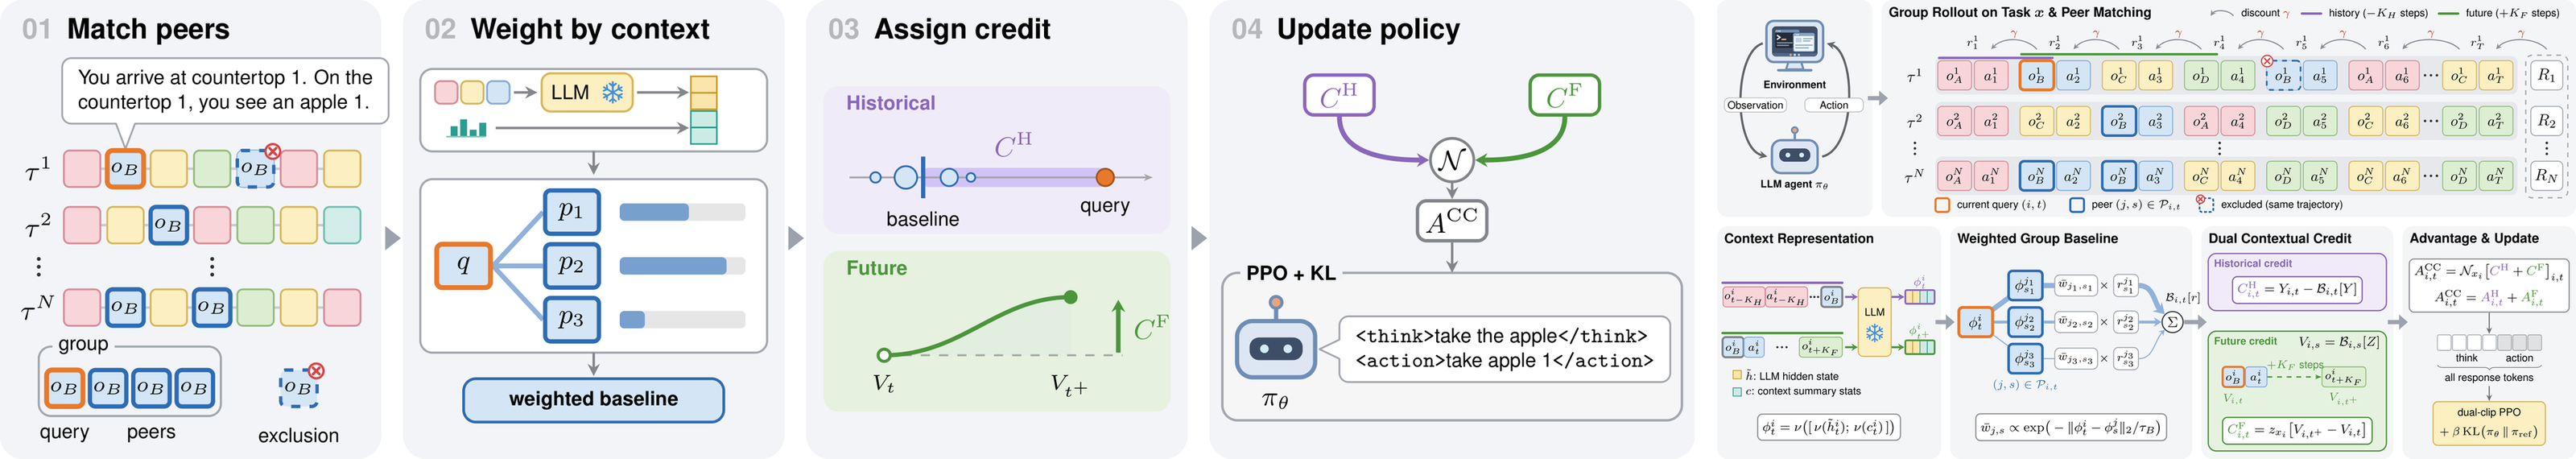
CCPO
Contextual Credit Policy Optimization

Huiwen Han, Ziyao Zeng, Zihao Zhu, Sisong Bei, Hao Wang, Hongyu Xu, Yan Han, Degui Zhi, Zhiwen Fan

Preprint | project page, code, paper

LLM Agents
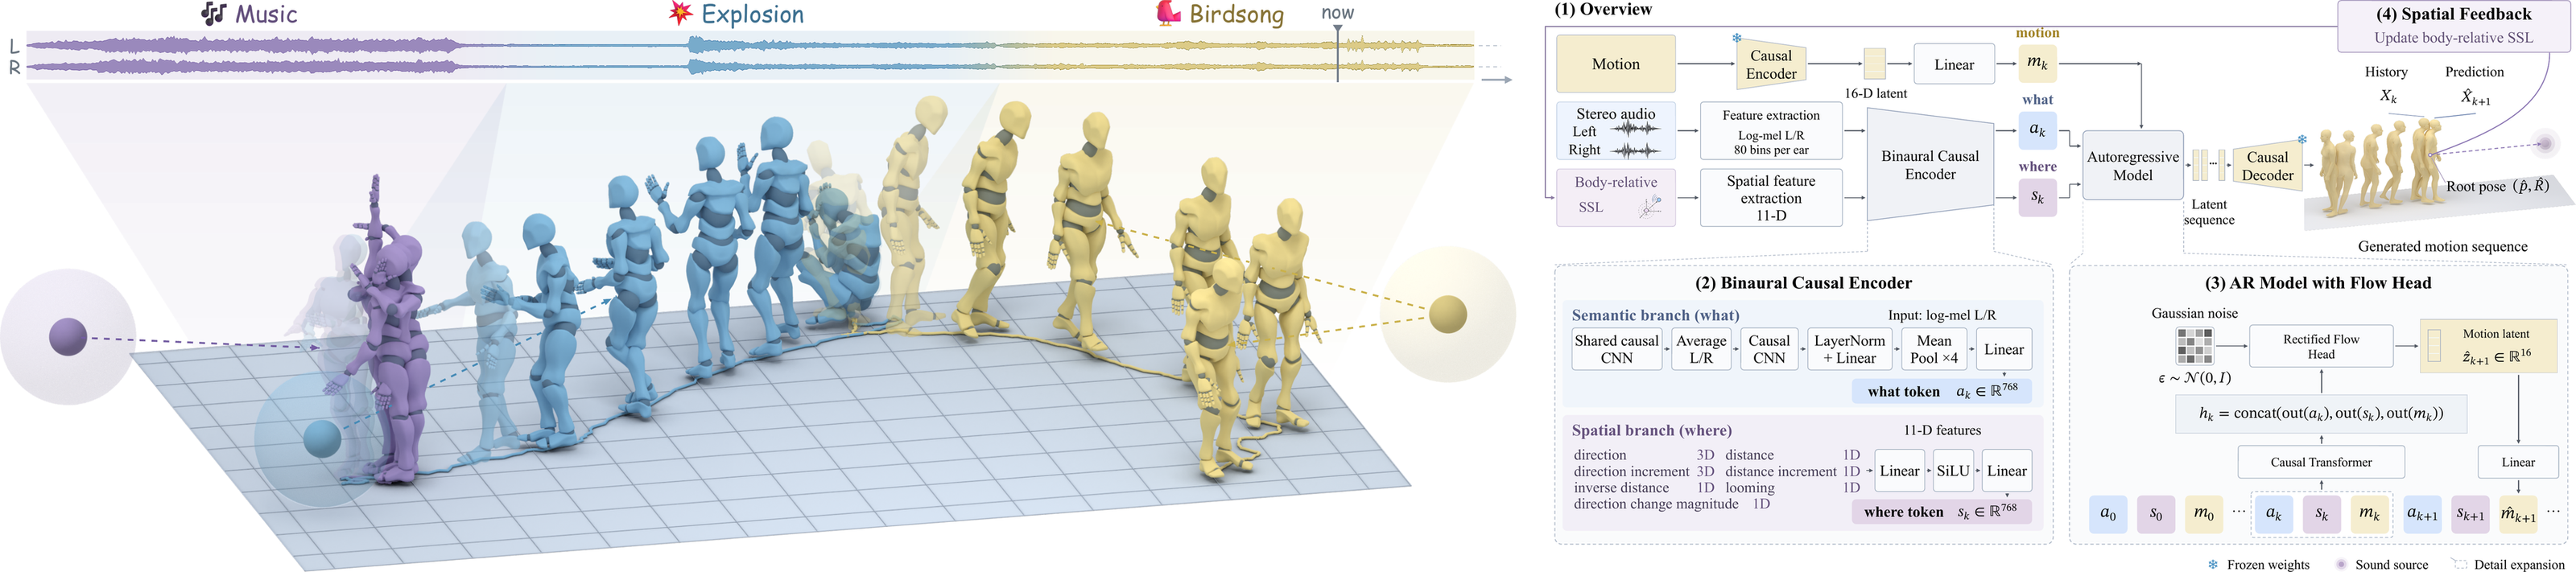
Sonic-AMG
Sonic-AMG: Streaming Human Motion Generation from Spatial Audio

Jingcheng Ni, Zekun Li, Zhiyang Dou, Xiaoyan Cong, Ziyao Zeng, Hongyang Du, Randall Balestriero, Taku Komura, Srinath Sridhar

Preprint | project page, paper

Multimodal
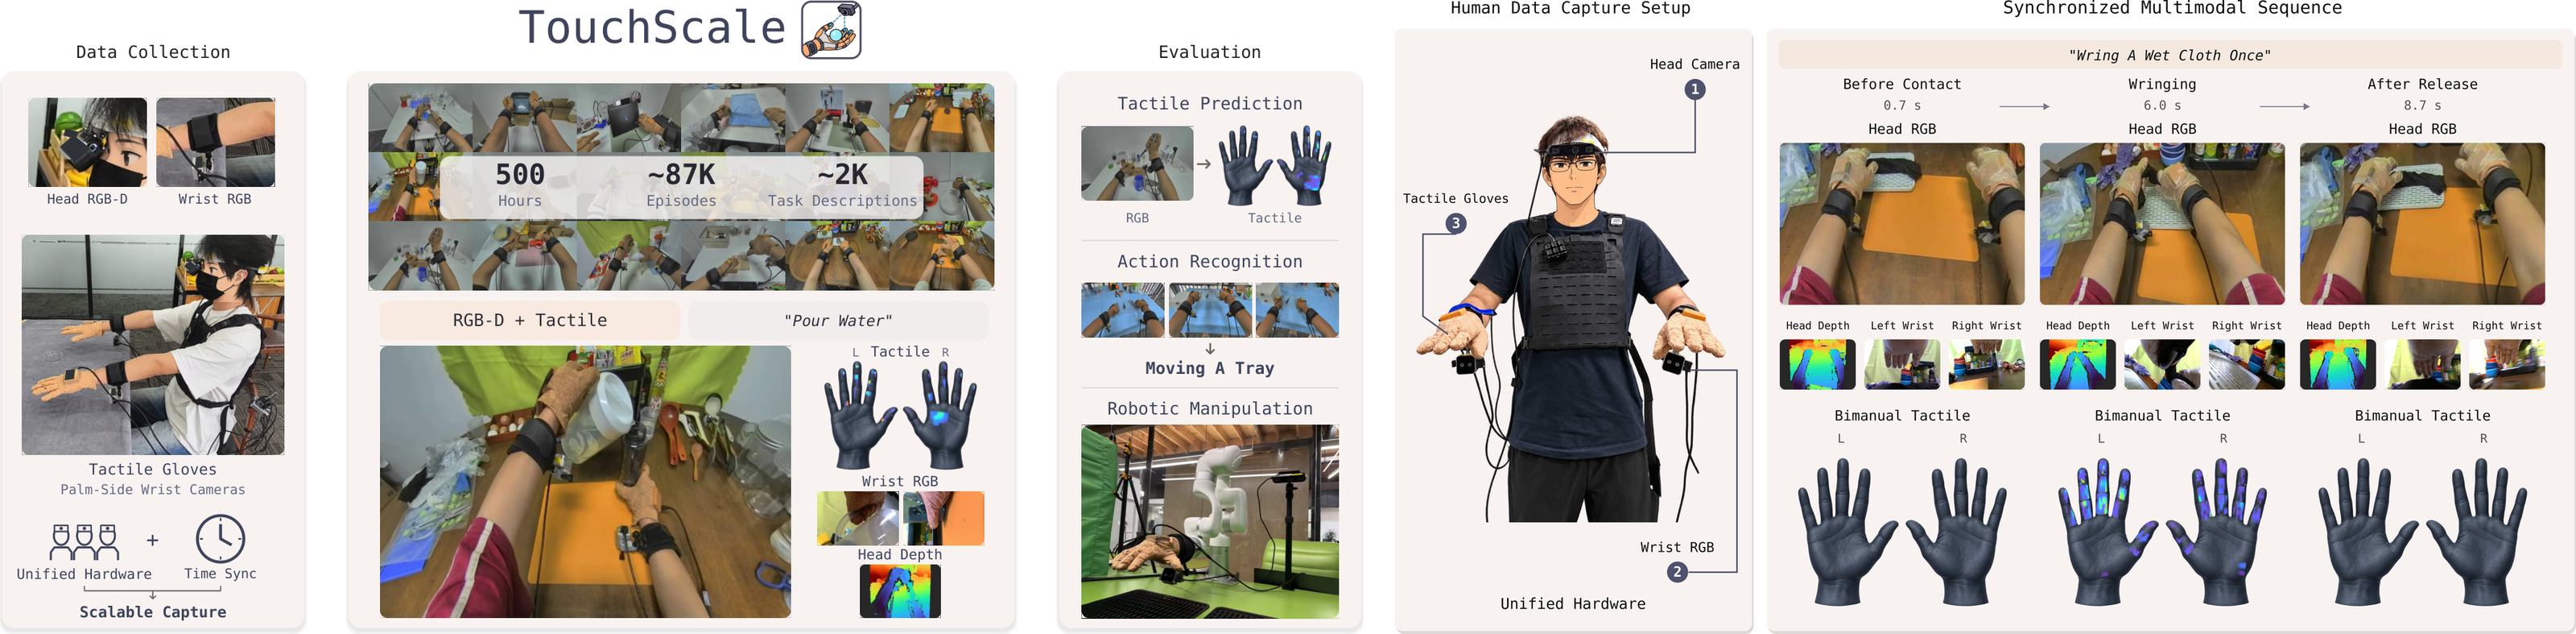
TouchScale
TouchScale: 500 Hours of Human Vision and Touch for Visual–Tactile Learning

Dayou Li*, Hao Wang*, Qianqian Yang*, Zihao Zhu*, Haoquan Fang, Ziyao Zeng, Yan Han, Zihan Wang, Yan Wang, Baoru Huang, Dilin Wang, Kenji Shimada, Yiyue Luo, Manling Li, Teresa Lv, Mustafa Mukadam, Rakesh Ranjan, Ruohan Zhang, Qi He, Changliu Liu, Xu Chen, Marco Pavone, Bangya Liu, Jiachen Li, Masayoshi Tomizuka, Zhiwen Fan

Preprint | project page, code, dataset, paper

MultimodalRobotics
4DP-QA
4DP-QA: Scalable QA for 4D Perception in Vision Language Models

Seokju Cho, Abhishek Badki, Hang Su, Jindong Jiang, Ziyao Zeng, Seungryong Kim, Sifei Liu, Orazio Gallo

CVPR 2026 | project page, paper

VLMs3D Vision
UniTac
UniTac: A Unified Multimodal Model for Cross-Sensor Understanding and Generation

Jiahang Tu, Fengyu Yang, Chenyang Ma, Xihang Yu, Ziyao Zeng, Shaokai Wu, Hanbin Zhao, Zhi Tao, Chao Zhang, Hui Qian, Alex Wong

ECCV 2026 (Oral) | paper

VLMsMultimodal
CrashTwin
A Physics-Grounded Benchmark for Multi-Agent Dynamics in World Models

Nuo Chen, Lulin Liu, Zihao Li, Ziyao Zeng, Zihao Zhu, Wenyan Cong, Junyuan Hong, Yunhao Yang, Zhengzhong Tu, Yan Wang, Boris Ivanovic, Marco Pavone, Zhangyang Wang, Yang Zhou, Zhiwen Fan

ECCV 2026 (Oral) | project page, code, paper

Diffusion (World) Models
OpenLongTail
OpenLongtail: Generative Scaling of Long-Tail Driving Data

Lulin Liu, Nuo Chen, Yan Wang, Bangya Liu, Wenyan Cong, Hezhen Hu, Boris Ivanovic, Hao Wang, Ziyao Zeng, Xinyu Gong, Yang Zhou, Zixiang Xiong, Dilin Wang, Zhangyang Wang, Weisong Shi, Ruohan Zhang, Marco Pavone, Zhiwen Fan

Preprint | project page, code, paper

Diffusion (World) Models
AFP
Artificial Foveated Perception for Mitigating Shortcut Learning in Robotic Foundation Models

Xiatao Sun, Yuan Zhuang, Mateo Sanchez Lopez Negrete, Matei-Victor Coldea, Chen Liang, Haoyang Zhang, Che Liu, Ziyao Zeng, Shawn Li, Qian Wang, Fei Miao, Daniel Rakita

CoRL 2026 | paper

VLMsRobotics

2025

Coffee
Coffee: Controllable Diffusion Fine-tuning

Ziyao Zeng, Jingcheng Ni, Ruyi Liu, Alex Wong

Preprint

Diffusion (World) Models
ETA
ETA: Energy-based Test-time Adaptation for Depth Completion

Younjoon Chung*, Hyoungseob Park*, Patrick Rim*, Xiaoran Zhang, Jihe He, Ziyao Zeng, Safa Cicek, Byung-Woo Hong, James S. Duncan, Alex Wong

ICCV 2025

3D Vision
ProtoDepth
ProtoDepth: Unsupervised Continual Depth Completion with Prototypes

Patrick Rim, Hyoungseob Park, S. Gangopadhyay, Ziyao Zeng, Younjoon Chung, Alex Wong

CVPR 2025 | project page, code

3D Vision
HOMER
HOMER: Homography-Based Efficient Multi-view 3D Object Removal

Jingcheng Ni*, Weiguang Zhao*, Daniel Wang, Ziyao Zeng, Chenyu You, Alex Wong, Kaizhu Huang

Preprint

3D Vision

2024

RSA
RSA: Resolving Scale Ambiguities in Monocular Depth Estimators through Language Descriptions

Ziyao Zeng, Yangchao Wu, Hyoungseob Park, Daniel Wang, Fengyu Yang, Stefano Soatto, Dong Lao, Byung-Woo Hong, Alex Wong

NeurIPS 2024 | code

VLMs3D Vision
NeuroBind
NeuroBind: Towards Unified Multimodal Representations for Neural Signals

Fengyu Yang*, Chao Feng*, Daniel Wang*, Tianye Wang, Ziyao Zeng, Zhiyang Xu, Hyoungseob Park, Pengliang Ji, Hanbin Zhao, Yuanning Li, Alex Wong

Preprint

VLMsMultimodal

2023

WorDepth
WorDepth: Variational Language Prior for Monocular Depth Estimation

Ziyao Zeng, Daniel Wang, Fengyu Yang, Hyoungseob Park, Yangchao Wu, Stefano Soatto, Byung-Woo Hong, Dong Lao, Alex Wong

CVPR 2024 | code

VLMs3D Vision
UniTouch
Binding Touch to Everything: Learning Unified Multimodal Tactile Representations

Fengyu Yang*, Chao Feng*, Ziyang Chen*, Hyoungseob Park, Daniel Wang, Yiming Dou, Ziyao Zeng, Xien Chen, Rit Gangopadhyay, Andrew Owens, Alex Wong

CVPR 2024 | project page, code

VLMsMultimodal

2022

PointCLIPv2
PointCLIP V2: Prompting CLIP and GPT for Powerful 3D Open-world Learning

Xiangyang Zhu*, Renrui Zhang*, Bowei He, Ziyu Guo, Ziyao Zeng, Zipeng Qin, Shanghang Zhang, Peng Gao

ICCV 2023 | code

VLMs3D Vision
iQuery
iQuery: Instruments as Queries for Audio-Visual Sound Separation

Jiaben Chen, Renrui Zhang, Dongze Lian, Jiaqi Yang, Ziyao Zeng, Jianbo Shi

CVPR 2023 | code

Multimodal
DepthCLIP
Can Language Understand Depth?

Renrui Zhang*, Ziyao Zeng*, Ziyu Guo, Yafeng Li

ACM Multimedia 2022, accepted as Brave New Idea (Acceptance Rate<=12.5%) | code

VLMs3D Vision

2021

DSPoint
DSPoint: Dual-scale Point Cloud Recognition with High-frequency Fusion

Renrui Zhang*, Ziyao Zeng*, Ziyu Guo, Xinben Gao, Kexue Fu, Jianbo Shi

SMC 2023 | code

3D Vision
VT-CLIP
VT-CLIP: Enhancing Vision-Language Models with Visual-guided Texts

Longtian Qiu, Renrui Zhang, Ziyu Guo, Ziyao Zeng, Yafeng Li, Guangnan Zhang

Preprint

VLMs
Twitter Emotion
Twitter Emotion Classification

Yiteng Xu*, Ziyao Zeng*, Jirui Shi*, Shaoxun Wu*, Peiyan Gu*

Final Project of CS181 Artificial Intelligence, 2021 Fall, ShanghaiTech University | code

Generalized DUQ
Generalized DUQ: Generalized Deterministic Uncertainty Quantification

Zhitong Gao*, Ziyao Zeng*

Final Project of CS282 Machine Learning, 2021 Spring, ShanghaiTech University

2020

Noisy Labels
Seek Common while Shelving Differences: A New Way for dealing with Noisy Labels

Zhitong Gao*, Ziyao Zeng*

Final Project of CS280 Deep Learning, 2020 Fall, ShanghaiTech University

Others

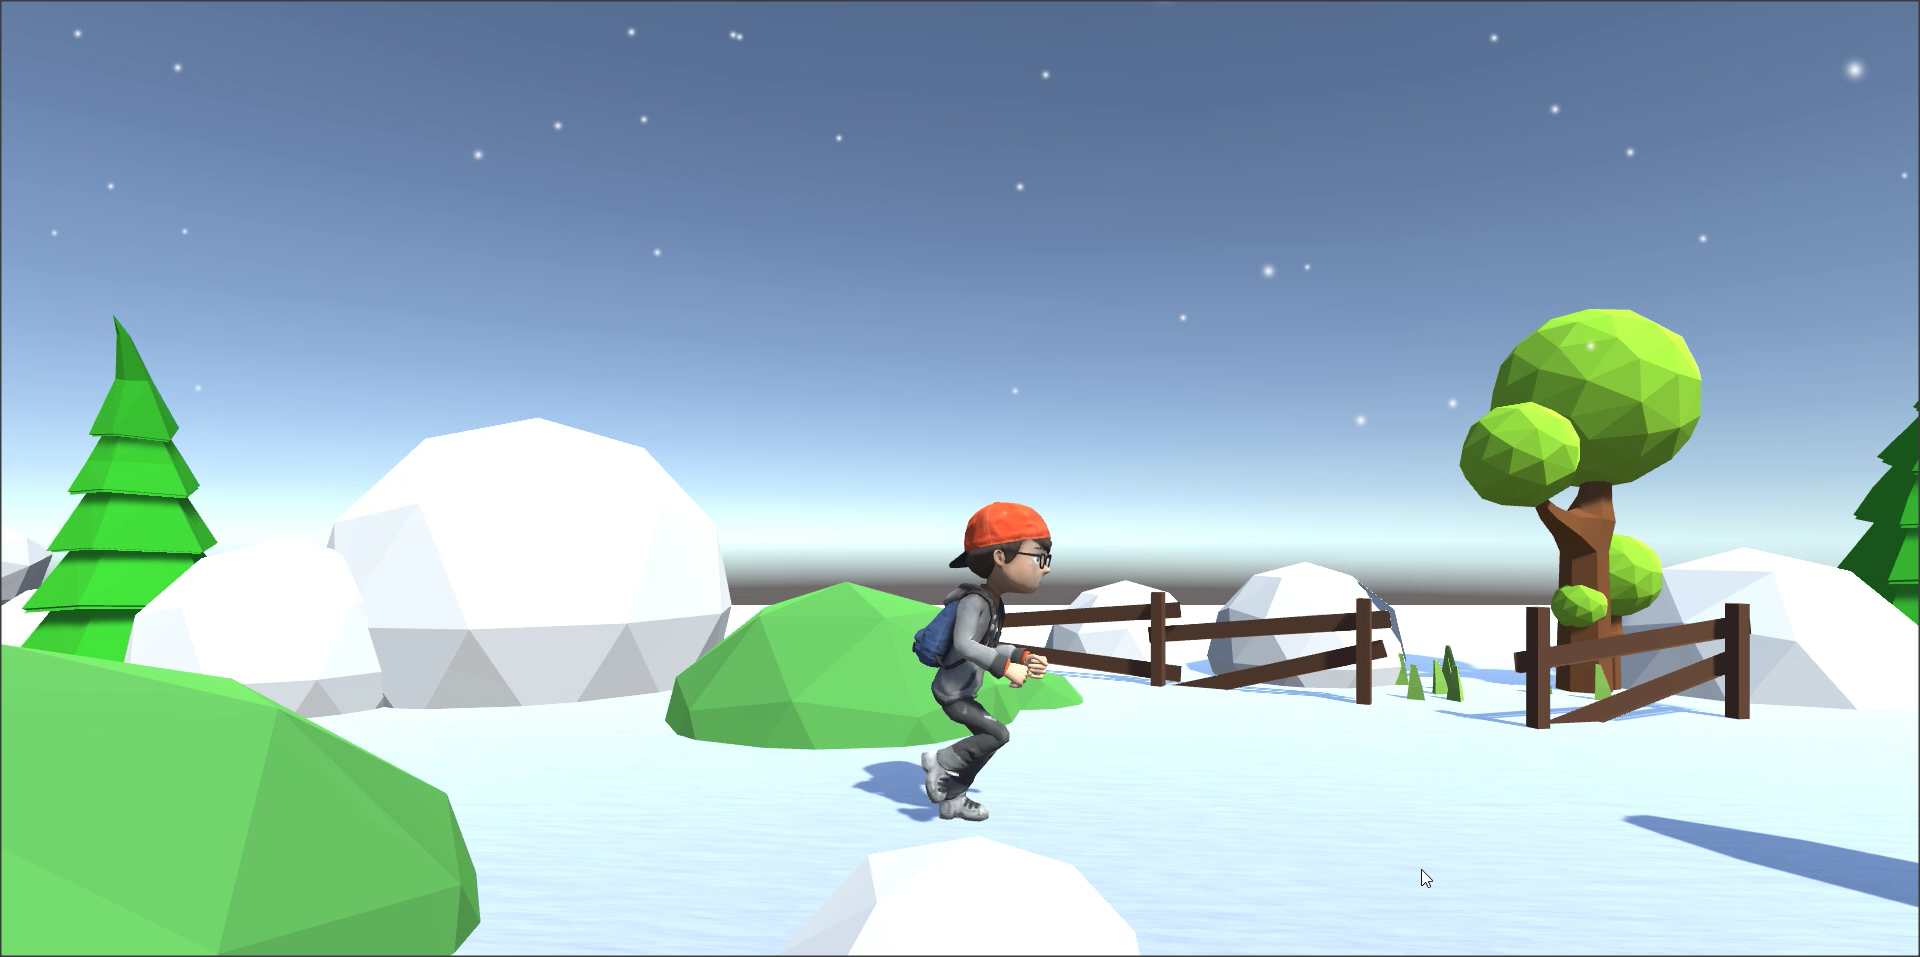
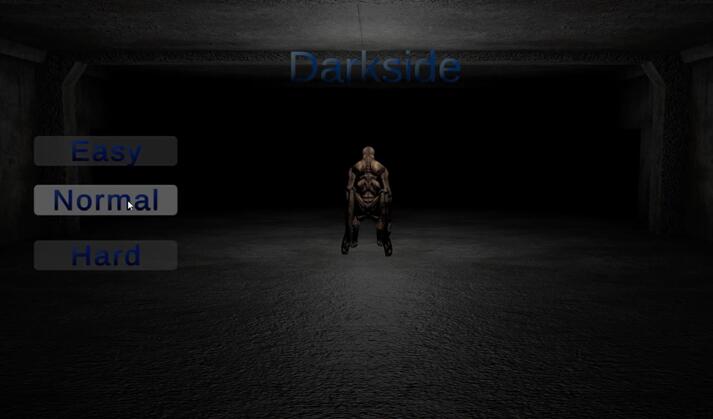
Unity Game Development

I'm an amateur Unity game developer, previous supervised by Brain Cox, screenshots of my previous works have been shown below.

Snow Ranger

Snow Ranger

Music & Arts

I'm also an amateur pianist, trombone player, guitar player, and Chinese folk singer.

I have been playing Tarot since 2014, dedicating to combining Tarot with modern psychology to serve as a tool for consciousness.

Volunteering

Previously, I volunteered at WWF-China and Greenpeace

Page views

since 2026/07/24